
一次语音通话中,发送端每 20 ms 编出一个音频包,但包在网络里并不会每隔 20 ms 准时到达:有的堵在路由器里,有的乱序,有的永远丢失。扬声器却不能说“再等一会儿”。播放设备持续索要下一段 PCM,晚交一次,就可能听见卡顿。
NetEQ 要解决的核心矛盾是:输入的时间不可靠,输出的时间必须可靠。 它在接收端保留少量音频作为余量,并根据网络变化调整等待与消耗速度;真正来不及的内容,则用已有声音生成替代片段。本文以本地 WebRTC 源码提交 3dec7d0537(2026-10-23)为准。此前的音频丢包恢复文章侧重 FEC、RED、NACK 与 PLC 的协作;这里把镜头推进 NetEQ 内部。
一、先从一场“迟到的声音”说起
假设一个包承载 20 ms 音频,P1、P2、P3 对应连续的三个时间段。网络先送来 P1,接着 P3 到了,P2 却堵在路上。接收端有两个选择:立刻播放 P3,会跳过 P2 的声音;继续等 P2,则可能使扬声器断粮。一个缓冲区能给 P2 留一点追上的时间,但缓冲越长,说话到听见的时间也越长。
| |
这里有三种性质不同的缺口:尚未到达的包可以等;已经错过播放时刻的包不能再补到过去;发送端主动停发的静音可能属于 DTX,应播放舒适噪声,而非误判为网络丢失。NetEQ 需要同时辨认这些情况。NetEq::GetAudio() 接口明确要求每次交付 10 ms;RTP 包时长却未必是 10 ms。
下面的动态图把这个过程压缩成一个教学示意:上排的包间隔不匀,中间会暂存、排序,下排每个播放刻度持续输出;紫色表示通过拉伸现有音频“省着用”,橙色表示缓冲过多时加速消耗,红色表示截止时没有可用音频而进行隐藏。图中的格数、时刻与阈值不对应源码常量。
二、NetEQ 在接收链路的什么位置
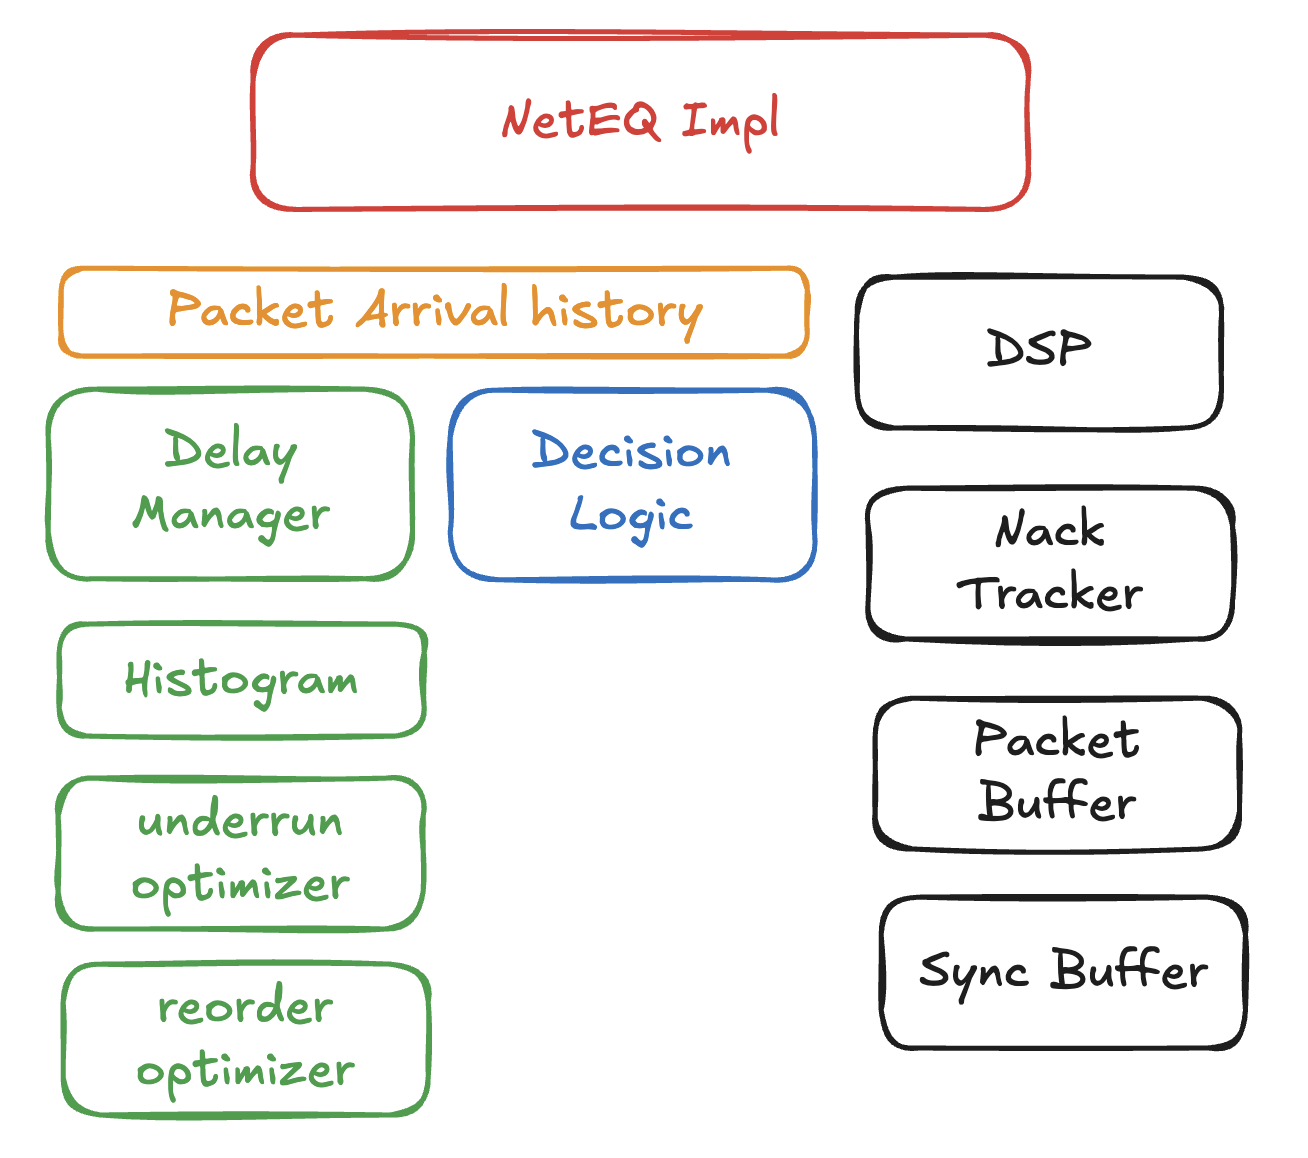
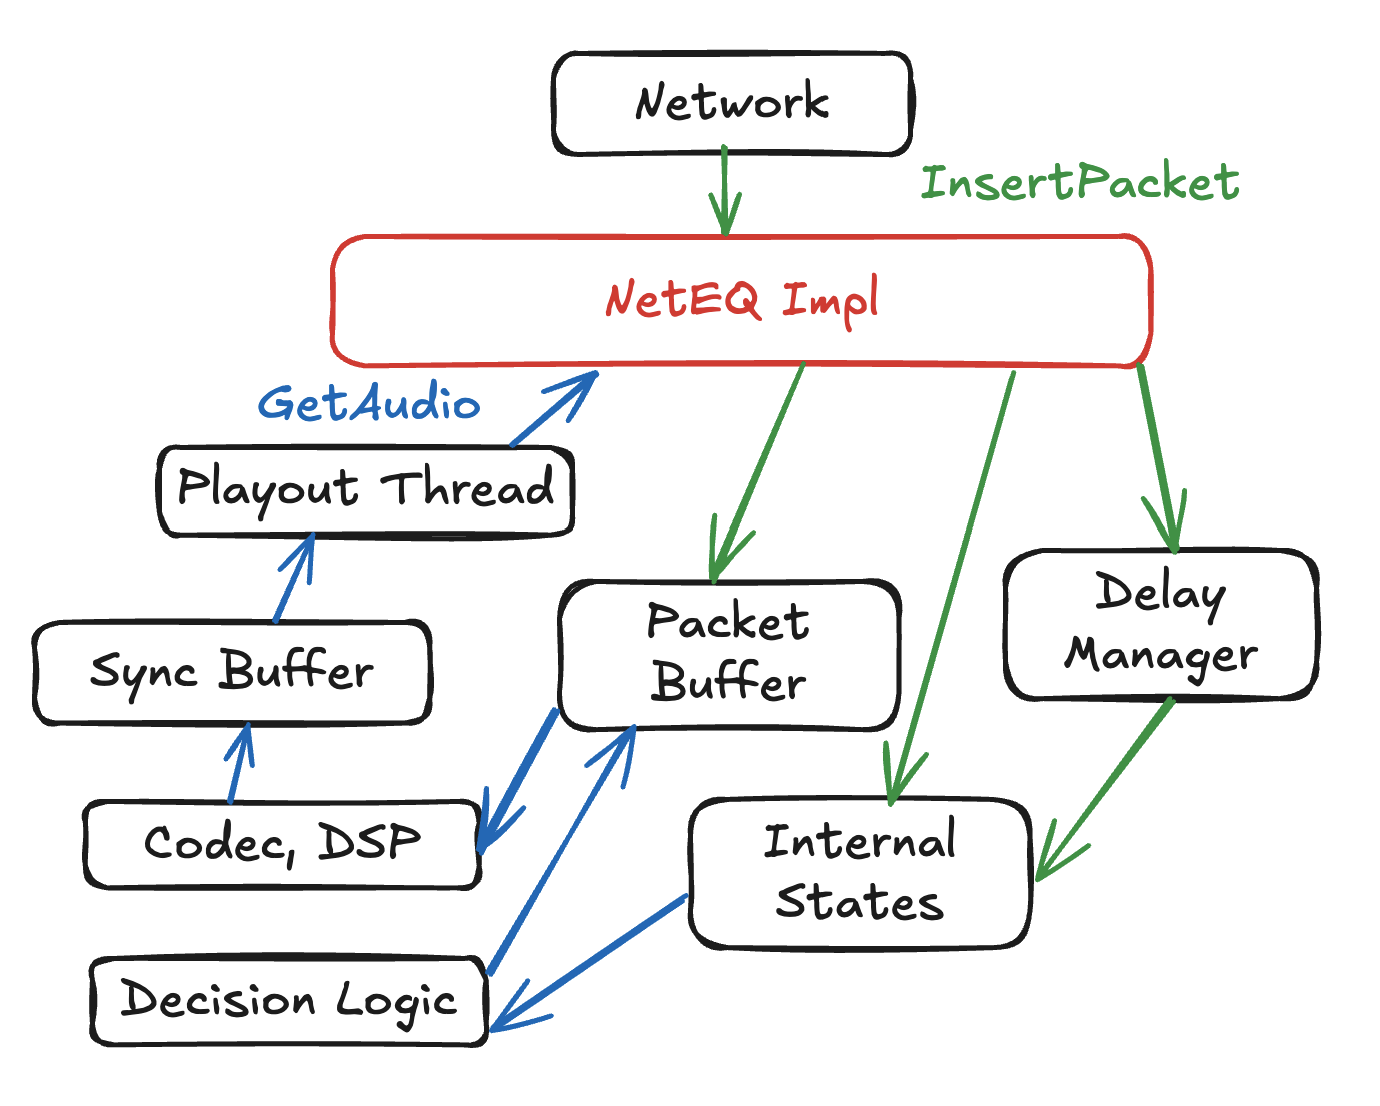
这是到包和取音频两条异步路径。网络侧调用 InsertPacket() 时,NetEQ 主要保存编码数据、更新延迟估计;设备侧通过接收流调用 GetAudio(),才决定此刻要解码哪一帧、是否修整时长,并取走 10 ms PCM。因此“收到了一个 RTP 包”不等于“立刻解码并播放一个包”。一个 20 ms 编码帧也可能在一次取音频时解码,分两次向设备交付。NetEqImpl::InsertPacket · NetEqImpl::GetAudioInternal
这里至少有两层缓冲,不能混为一谈:
| 层 | 保存什么 | 为什么需要 |
|---|---|---|
PacketBuffer | 尚未使用的编码帧,按音频时间戳与优先级排列 | 容纳到达抖动、乱序、冗余帧;供解码器按播放顺序取用 |
SyncBuffer | 已解码、经过处理但尚未交付的 PCM,以及算法需要的历史/重叠区 | 让“解码一帧”与“固定交付 10 ms”解耦,并支撑伸缩、隐藏与拼接 |
InsertPacket() 并非简单把原始 RTP 载荷塞进队列:它先处理时间戳,必要时拆开 RED、识别 DTMF/CNG,再让对应解码器的 ParsePayload() 解析主帧与可能的冗余帧。随后编码帧进入 PacketBuffer,到包信息进入延迟估计器。PacketBuffer 不是无限队列:包过多会触发丢弃或刷新;同一音频时间戳的主帧和冗余帧会按优先级取舍。SyncBuffer 里已有足够的 PCM 时,本次 GetAudio() 可以直接交付,不必再取新的编码帧。插包与解析 · 包排序和容量处理 · 同步缓冲提取
三、该为迟到的包多留多少时间?
上一节看到,NetEQ 先把到达的包存起来,再按播放设备的节拍取出音频。为什么要存?为了给偶尔晚到的包留一个追上的机会。 但每多留一点时间,听到对方说话也会晚一点。第三节只讨论这个取舍:播放前应留多少余量。
看一个简化例子。P1 在第 0 ms 到达;P2 承载的是接下来的 20 ms 音频,按稳定的到包节奏应在第 20 ms 左右到,实际却在第 50 ms 才到。P2 相对平时额外晚了 30 ms。假设 NetEQ 从 P1 到达起,给播放预留以下时间:
| 预留的播放余量 | P2 开始播放的时刻 | P2 到达时刻 | 结果 |
|---|---|---|---|
| 20 ms | 第 40 ms | 第 50 ms | P2 开头的 10 ms 错过播放时刻;后半段能否使用取决于当时的缓冲状态 |
| 40 ms | 第 60 ms | 第 50 ms | 提前 10 ms 赶上;整路播放也比上面多等 20 ms |
下图把“测晚到量 → 定目标 → 调实际缓冲”连起来。第一层的 30 ms 只是 P2 的一次观测;第二层才汇总近期多个包,形成抖动缓冲(jitter buffer)的目标延迟。第三层的 20 / 40 ms 延续上表,仅用来对比两种播放余量:虚线表示目标,实心表示实际缓冲。目标改变后,实际缓冲需要靠后续到包和播放侧调节逐步靠近,不会瞬间跳到虚线位置。
表和图中的数值只用于说明等待和实时性的交换,并非 NetEQ 的固定启动流程或阈值。留得太少,晚包容易错过,NetEQ 只好隐藏缺口;留得太多,声音虽更平稳,对话却变得迟钝。合适的余量要随网络变化:网络最近常抖,就多留一点;到包稳定了,再尝试缩短等待。真正丢失的包无论等多久都不会到,不能靠不断加大缓冲解决。
对照源码:NetEQ 怎样估计这份余量
NetEQ 并不需要知道“P2 从发送端到接收端究竟走了多少毫秒”。PacketArrivalHistory 比较包的到达间隔和它们在 RTP 音频时间轴上的间隔;上例的差值就是约 30 ms 的相对晚到量。DelayManager 分别估计常规晚到需要的余量,以及为了接住乱序包值得付出的额外等待,取两者中较大的目标。当前版本对常规晚到默认每 500 ms 取窗口最大值,再从近期分布中选 0.95 分位;初始估计为 80 ms。这些是策略参数,不表示每次 GetAudio() 都先等 80 ms,也不表示一个 P2 的 30 ms 晚到会立刻把目标设为 40 ms。目标还会受配置的最小/最大延迟及缓冲容量限制。相对晚到量 · 延迟目标 · 分位数估计 · 乱序取舍 · 延迟约束
目标延迟像一条希望维持的水位线,而不是能瞬间填满缓冲区的命令。下一节再看:实际音频比这条线多或少时,NetEQ 如何在每次取音频时调整。
四、每次 GetAudio() 究竟会做什么
GetAudioInternal() 先整理状态:下一包时间戳、编码缓冲跨度、SyncBuffer 里还剩多少样本、上一轮的输出模式。DecisionLogic 据此选操作;主实现还会根据实际可用样本、DTX 包等条件修正决定,然后解码、处理、写入 SyncBuffer,最后取出恰好 10 ms。状态构造与修正 · 输出处理
| 场景 | 可能的操作 | 听到什么 |
|---|---|---|
| 期待的音频帧已到,缓冲合适 | Normal | 解码并正常输出;若 SyncBuffer 已够,直接取现有 PCM |
| 有可用音频,但实际延迟偏高 | Accelerate / FastAccelerate | 尽量在相似波形处缩短音频,消耗积压 |
| 有可用音频,但实际延迟偏低 | PreemptiveExpand | 在已有音频中平滑插入一小段,减缓消耗 |
| 期待的时间段无包可用 | Expand 或解码器 PLC | 依据历史生成替代音频,维持设备输出 |
| 隐藏后恢复了真实语音 | Merge 或 Normal | 把替代音频与新解码音频衔接起来 |
| 发送端静音、CNG/DTX 或电话按键 | 舒适噪声 / Dtmf | 按相应语义生成或叠加声音 |
表里写的是可能的操作,不是“每次都会成功执行”。Operation 表示本轮选了什么,Mode 表示处理后的实际状态:例如时间伸缩可能因为波形或样本条件不足而没有真正缩放。源码还给时间伸缩设了最短间隔,并要求至少一定长度的已解码音频;不能把高低水位想象成每 10 ms 都机械地删或补 10 ms。操作/模式定义 · 目标比较与决策 · 伸缩条件
时间伸缩为什么不等于变速播放
直接加快采样播放会抬高音调;直接复制一截样本又容易出现明显接缝。NetEQ 的 TimeStretch 在音频中寻找相似的周期与片段:先降采样、做相关性分析来估计合适的周期,再让 Accelerate 删去相似片段并交叉淡化,或让 PreemptiveExpand 插入相似片段并交叉淡化。低能量区有专门处理。它是在局部改变样本数量,不是把输出设备的采样率改成另一个值。TimeStretch::Process() · Accelerate · PreemptiveExpand
PreemptiveExpand 与丢包时的 Expand 不是一回事。 前者在有真实音频时主动微调速度,目的是积累缓冲余量;后者在该播放的音频缺失时生成隐藏音频,目的是避免断声。它们都可能插入样本,但统计和听感意义不同。
包真的没赶上时:隐藏与恢复
缺少目标时间戳对应的包时,DecisionLogic 会结合下一包是否在未来、当前是否处于 CNG/DTX、先前是否已经在隐藏,选择继续等、生成舒适噪声或进入 Expand。Expand 使用历史解码音频估计周期性语音、非周期成分和背景噪声;连续缺失越久,越难维持自然听感。若当前解码器实现了 GeneratePlc() 且确实产出音频,NetEQ 也可以使用解码器 PLC;否则回退到自己的 Expand。恢复正常帧后,若此前是 NetEQ Expand,Merge 会平滑接回真实音频。缺包决策 · PLC 回退 · Expand · Merge
如果 Opus FEC、音频 RED 或 NACK 及时送回了可用的编码数据,它们会在截止前进入正常的包选择路径;NetEQ 并没有一个“所有丢包一律先等重传”的固定顺序。音频 NACK 的反馈跟踪也位于 NetEQ 外部的接收链路。数据到了但已过播放点,不能把已经输出的 PCM 改写。最重要的判断仍是能否赶上播放截止时间。ChannelReceive 的 NACK 路径
五、真实 RTC 问题怎样定位与调整
调 NetEQ 前,先分清“网络根本没送到”和“送到了但太迟”。两者在主观听感上都可能是卡顿,但改动方向不同。可以同时记录包到达时间与 RTP 时间戳、TargetDelayMs()、FilteredCurrentDelayMs()、GetLifetimeStatistics() 和 GetOperationsAndState()。其中累计的 concealed_samples / concealment_events 反映隐藏量与事件数,inserted_samples_for_deceleration / removed_samples_for_acceleration 反映时间伸缩,packets_discarded 与 packet_buffer_flushes 有助于发现积压;jitter_buffer_target_delay_ms 之类累计字段应按统计定义计算平均值,不能直接当“当前目标延迟”。NetEq 统计接口 · TargetDelayMs 与 FilteredCurrentDelayMs
GetLifetimeStatistics() 的计数不会清零,适合用两次读数之差计算一段时间的变化;NetworkStatistics() 则会在读取后重置区间统计。后者的 expand_rate、accelerate_rate 等比率采用 Q14,换算百分比应除以 16384 再乘 100。CurrentNetworkStatistics() 只返回当前状态,不能拿它读取这些区间比率。静音/DTX 期间的缓冲估计也不能直接按普通语音期解读:遇到 DTX 包时,主实现会把伸缩操作改为 Normal。统计定义 · DTX 分支
| 现象与证据 | 优先排查 | 可评估的调整与代价 |
|---|---|---|
| Wi-Fi 抖动或乱序时,接收包最终齐全,但隐藏样本和迟到包增加 | 到包相对延迟分布、乱序比例、当前延迟是否频繁低于目标 | 适当提高最小延迟,给晚到包时间;代价是交互变慢。若损失为突发断网,单纯加缓冲通常收益有限 |
| 网络稳定,但说话明显慢半拍,缓冲长期高于目标 | 设备回调是否稳定、是否积压/刷新、Accelerate 是否成功 | 先查播放端是否按时拉取,再评估降低最小延迟或启用合适的加速策略;过小上限可能带来更多隐藏 |
| 连续丢包后声音变机械,恢复时有接缝 | concealment_events、连续隐藏长度、FEC/RED/NACK 是否赶上截止 | 优先改善上游链路与编码保护;可对比解码器 PLC 与 NetEQ Expand,但两者都无法复原未知原声 |
| 静音段被当成丢包,产生无意义的补偿或统计异常 | 是否发送 DTX/CNG、载荷类型与解码器协商是否一致 | 正确传递静音语义;不要用纯序号缺口推断每个缺口都应是语音 |
| 长时间播放阻塞后出现很高延迟或一次明显跳音 | PacketBuffer 数量、刷新计数、设备线程阻塞时长 | 修复播放回调卡顿;缓冲上限/智能刷新只能限制积压后果,无法让已错过的播放时刻回来 |
原生 WebRTC 集成可以通过 NetEq::Config 设置 min_delay_ms、max_delay_ms、max_packets_in_buffer,运行时通过 SetMinimumDelay()、SetMaximumDelay()、SetBaseMinimumDelayMs() 调整约束。enable_fast_accelerate 允许使用更激进的加速分支;它是质量与追赶速度的取舍,不应作为“延迟高”的默认第一步。SetMaximumDelay(0) 表示不额外限制最大目标;最小延迟、最大延迟和实际缓冲容量还要满足约束关系,调用失败应检查返回值。若确实要研究目标延迟估计策略,WebRTC-Audio-NetEqDelayManagerConfig field trial 能调整分位数、遗忘因子和乱序优化参数;这适合在可控源码构建里做对照实验,不宜在没有数据时直接改默认值。配置与 API · 约束实现 · 延迟管理器配置
这些是 NetEQ 原生接口,不等于浏览器 JavaScript 可以逐项直接设置。应用层若使用浏览器 RTCPeerConnection,应先确认浏览器暴露的延迟控制与接收统计,再在可控制的层面做实验;不能把改 C++ 内部参数的建议直接写成网页端可用的开关。
一个有效的调优实验应固定编解码器、包时长、设备链路与端到端延迟预算,分别注入纯抖动、乱序、孤立丢包、连续丢包、播放回调阻塞。比较的不只是平均缓冲时长,还包括隐藏样本、刷新与丢弃、时间伸缩次数,以及实际通话听感。源码自带的 neteq_rtpplay 可以对同一份 RTP 输入做离线对比,帮助区分策略差异与网络输入差异。若只是把目标延迟加大,隐藏减少了却使对话明显变慢,问题并没有免费解决。
六、把 NetEQ 记成一个闭环
NetEQ 的价值在这个持续运行的闭环:按音频时间轴整理包,估计值得等待多久,按播放时钟每 10 ms 做一次决定,并在真实数据不足时维持连续输出。 它能在延迟、卡顿与失真之间找一个动态平衡,却不能突破播放截止时间,也不能从完全丢失的包里恢复原声。理解这条边界,才知道该调缓冲、修设备回调,还是回头解决网络和编码保护问题。