Mel Spectrogram 是语音识别、音频分类、音乐信息检索里非常常见的输入特征。它做的事情可以简单理解为:把一段一维波形,变成一张“符合人耳听觉习惯”的时间-频率能量图。
1. 从一段声音开始
计算机拿到的音频通常是一串采样点:
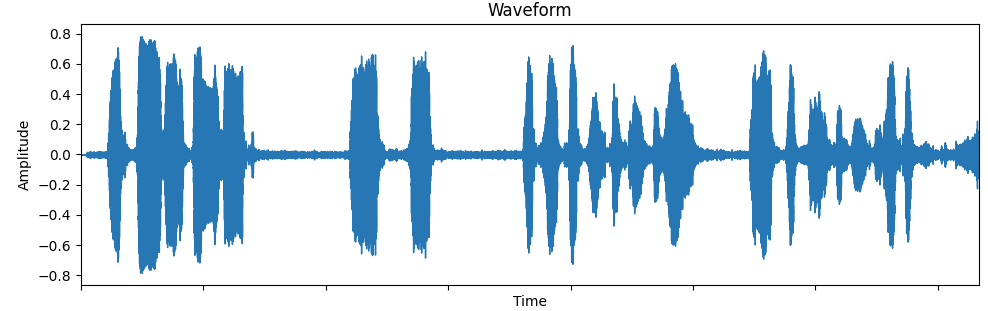
这串数字描述了空气振动随时间变化的幅度。问题是,直接看波形很难回答这些问题:
- 这段声音里有哪些频率?
- 某个频率是在什么时候出现的?
- 对人耳来说,哪些变化更重要?
所以我们需要一种更适合分析声音的表示。
2. 为什么不能只做一次 FFT?
FFT 可以告诉我们“一整段声音里有哪些频率”,但它会丢掉时间信息。
比如一段音频里先说 “a”,后说 “i”。如果直接对整段音频做 FFT,我们只能知道整段音频总体有哪些频率,不知道这些频率分别出现在什么时候。
语音是随时间变化的信号,所以更常用的是 STFT(Short-Time Fourier Transform,短时傅里叶变换)。
STFT 的做法是:
- 把音频切成很多短帧,比如每帧 25ms。
- 相邻帧之间有重叠,比如每 10ms 移动一次。
- 对每一帧分别做 FFT。
- 把每一帧的频谱按时间排起来。
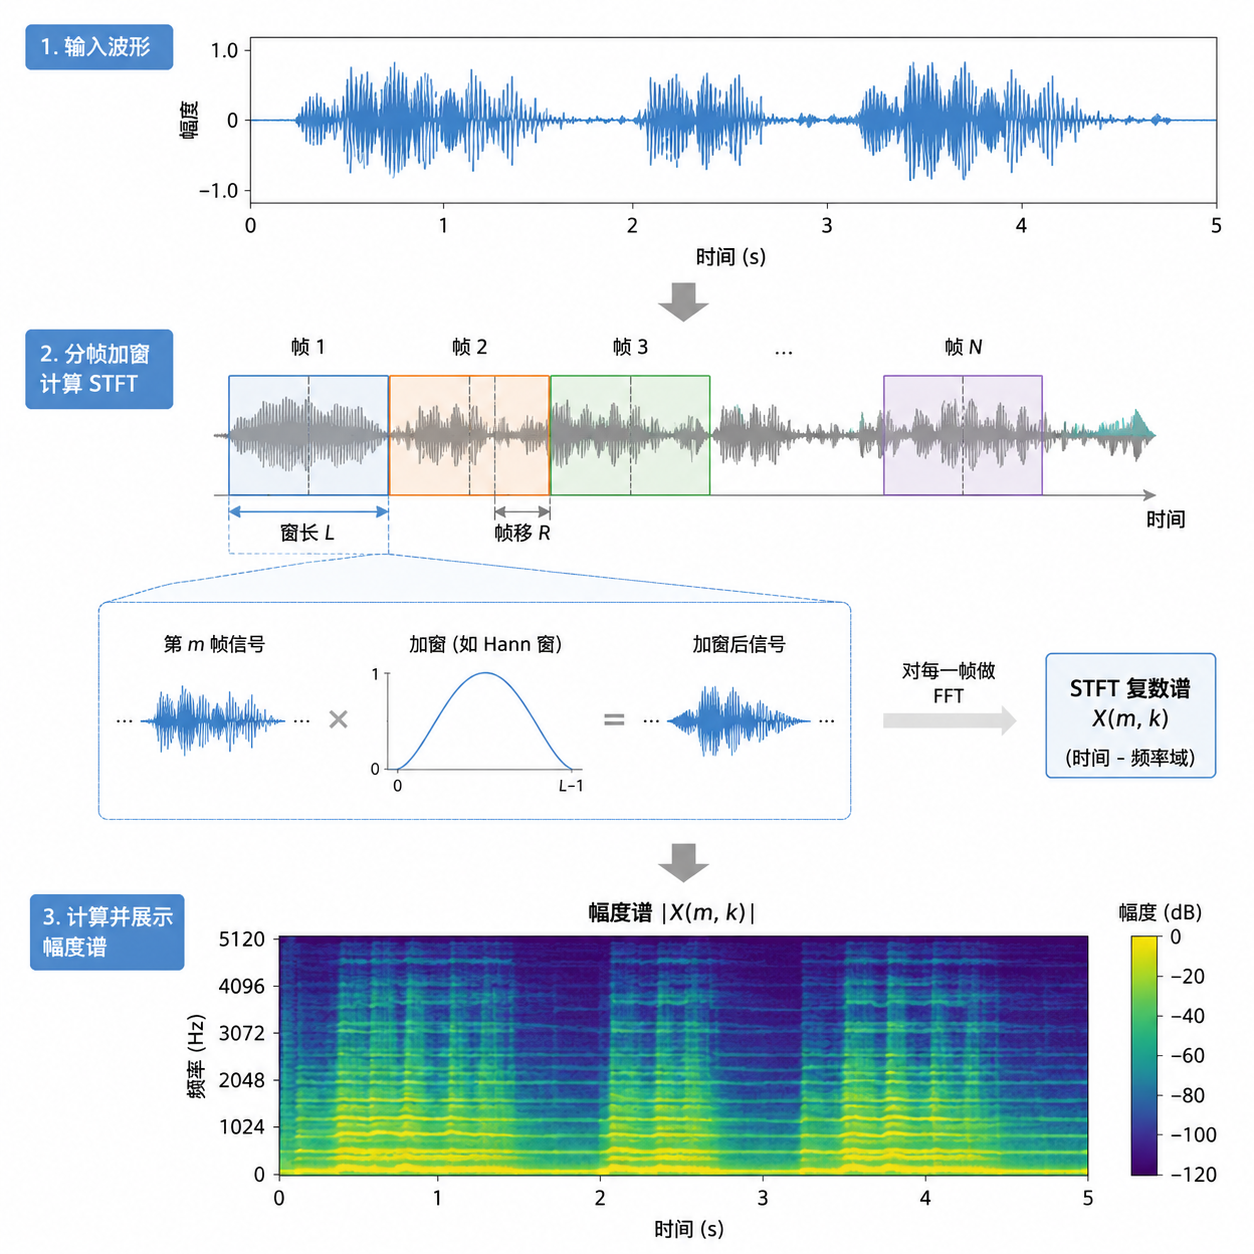
这张“横轴是时间,纵轴是频率,颜色表示能量”的图,就是 Spectrogram(声谱图)。
3. STFT 到底在算什么?
假设输入音频是 $x[n]$,第 $m$ 帧的起点是 $mH$,其中 $H$ 是 hop length。每帧先乘一个窗函数 $w[n]$,再做 FFT:
$$ X(m, k) = \sum_{n=0}^{N-1} x[n + mH] \cdot w[n] \cdot e^{-j2\pi kn/N} $$
其中:
| 符号 | 含义 |
|---|---|
| $N$ | FFT 点数,也通常是窗口大小附近的值 |
| $H$ | 帧移,决定相邻帧间隔 |
| $m$ | 第几帧,也就是时间维索引 |
| $k$ | 第几个频率 bin |
| $w[n]$ | 窗函数,常用 Hann window |
FFT 输出的是复数,实际做特征时通常取幅度谱或功率谱:
$$ P(m, k) = |X(m, k)|^2 $$
到这里得到的是普通线性频谱。它的频率刻度是线性的,比如 0Hz、100Hz、200Hz、300Hz …
4. 为什么要用 Mel 频率?
人耳对频率的感知不是线性的。
我们对低频变化更敏感,对高频变化相对迟钝。比如:
- 300Hz 到 400Hz 的变化,人耳容易感觉明显。
- 8000Hz 到 8100Hz 的变化,人耳通常没那么敏感。
这就像看地图:市区街道很密,需要细看;荒野区域可以粗略一些。Mel 频率就是一种“听觉地图投影”:低频区域分辨率高,高频区域分辨率低。
常用的 Hz 到 Mel 转换公式是:
$$ m = 2595 \log_{10}(1 + \frac{f}{700}) $$
反过来:
$$ f = 700(10^{m/2595} - 1) $$
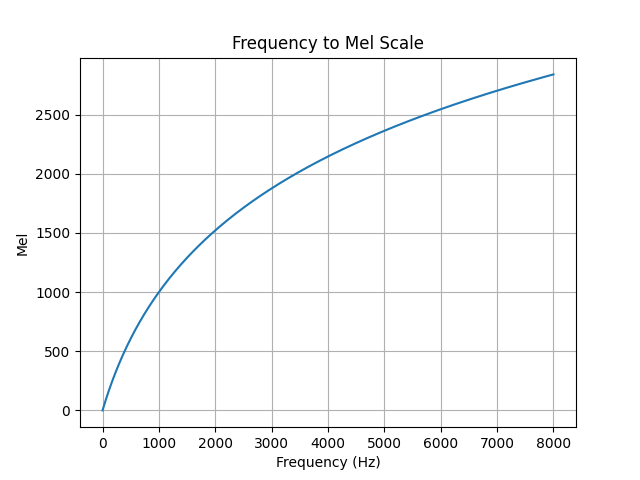
大致效果如下:
| |
5. Mel 滤波器组是什么?
Mel Spectrogram 的核心不是一个神秘算法,而是一组三角形滤波器。
它们铺在线性频谱上,每个滤波器负责统计一小段频率范围内的能量。低频处滤波器更窄、更密;高频处滤波器更宽、更稀。
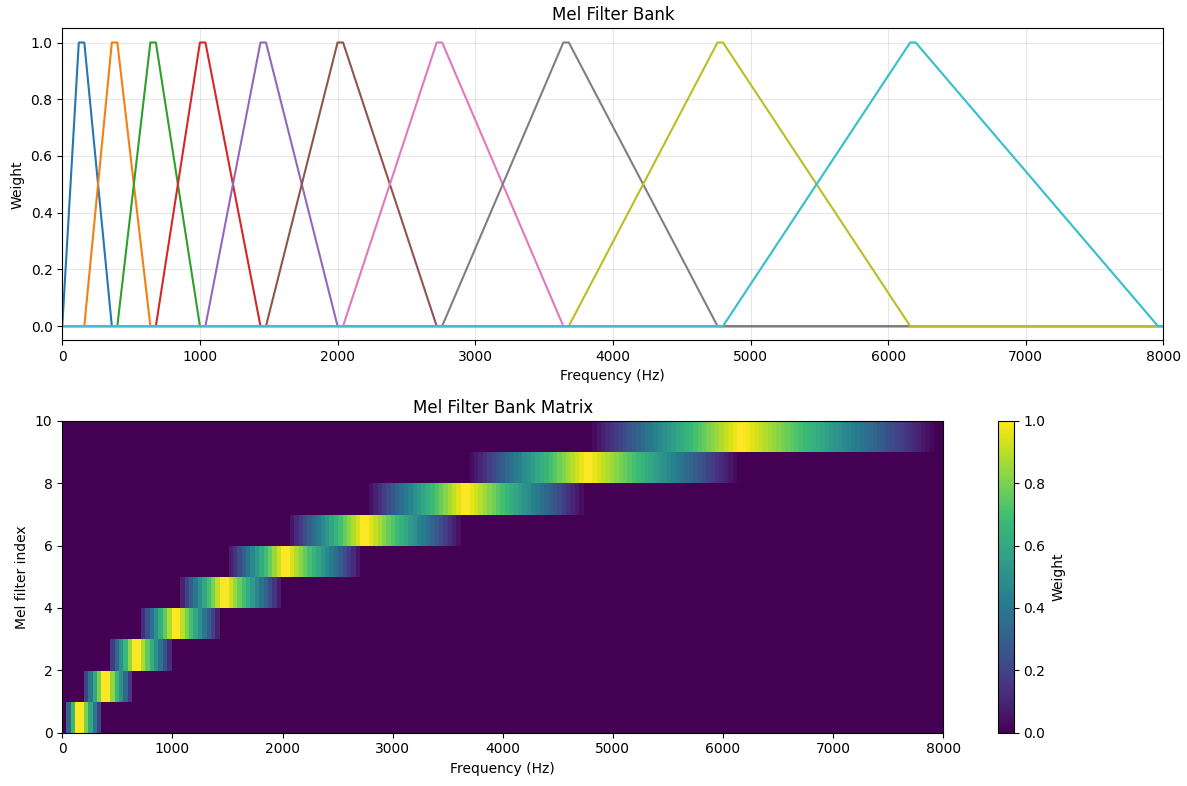
如果线性功率谱是 $P(m, k)$,Mel 滤波器组是 $M(i, k)$,那么第 $i$ 个 Mel 频带的能量为:
$$ S(m, i) = \sum_k P(m, k) \cdot M(i, k) $$
写成矩阵形式更直观:
$$ \text{MelPower} = \text{PowerSpectrogram} \times \text{MelFilterBank}^T $$
最终通常再做 log 压缩:
$$ \text{LogMel}(m, i) = \log(S(m, i) + \epsilon) $$
加上 $\epsilon$ 是为了避免 $\log(0)$。
Whisper 中的 Mel filter bank
Whisper 使用的 Mel filter bank 并不是在推理时临时手写生成的。OpenAI Whisper 里预先保存了 mel_filters.npz,其中 80 维版本的生成方式等价于:
| |
这里没有显式写出的默认参数也很重要:
| |
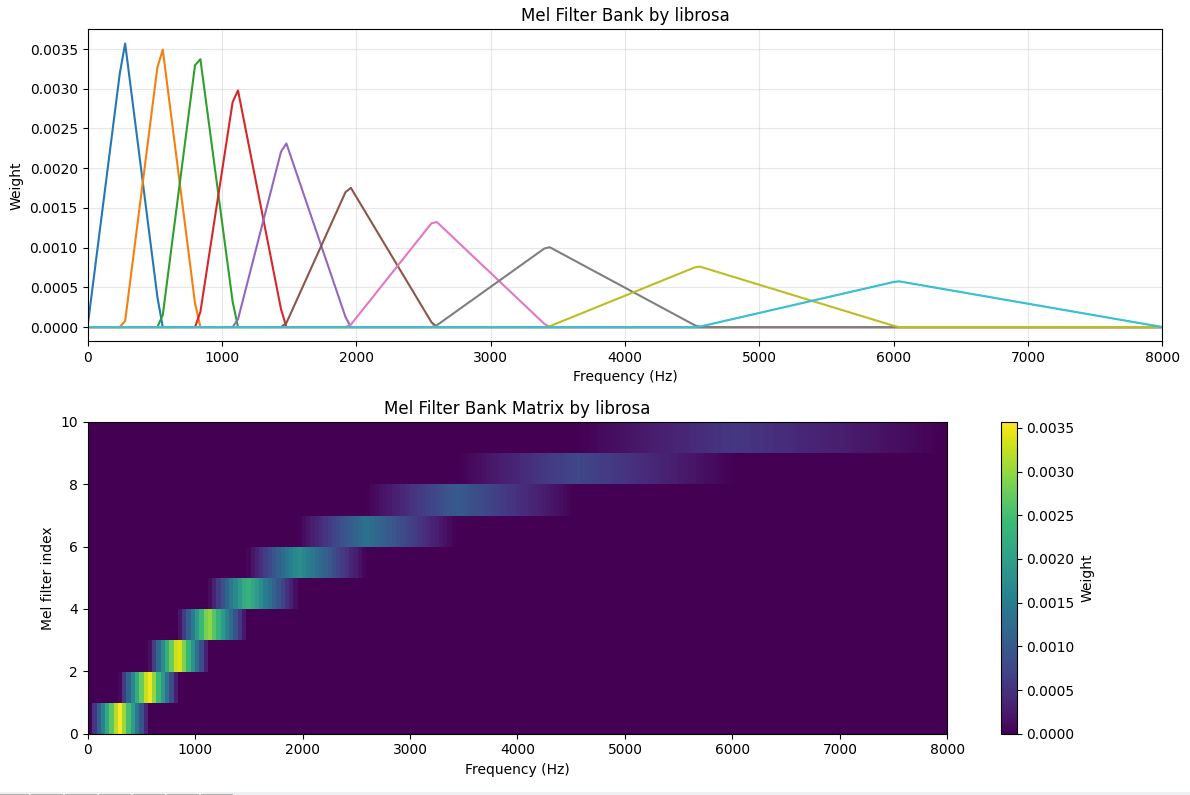
也就是说,Whisper 使用的是 Slaney 风格的 Mel 标尺,并且对 Mel filter 做了面积归一化。whisper.cpp 在模型转换时会把这组预计算好的 filter bank 写入 ggml 模型文件,运行时只是加载并使用这些系数。
面积归一化的含义是:三角滤波器不再追求每个峰值都等于 1,而是让每个滤波器覆盖区域的面积更接近一致。因为 Mel 滤波器在 Hz 轴上越往高频越宽,如果所有三角形峰值都固定为 1,高频滤波器会覆盖更多 FFT bin,自然累加出更大的能量。这会给高频 Mel band 带来额外偏置。
| |
因此,norm="slaney" 的好处不是让图形看起来更整齐,而是让 Mel 频带更接近“对一个频率区间的加权平均能量”,而不是简单“加权求和”。这能减少由于滤波器宽度不同造成的能量偏差,也保证推理时的输入特征分布和 Whisper 训练时保持一致。
6. 为什么模型喜欢 Log-Mel?
很多 ASR、音频分类模型并不直接吃原始波形,而是吃 Log-Mel 特征。原因主要有几个。
6.1 更接近人耳听觉
语音识别的目标不是还原波形,而是识别“人听到的内容”。Mel 刻度把频率轴变成更接近人耳感知的尺度,对语音任务很自然。
6.2 降低输入维度
以 16kHz 音频、400 点 FFT 为例,线性频谱有 201 个频率 bin。经过 Mel 滤波器组后,常见配置只保留 80 个 Mel bins。
| |
这相当于把不必要的频率细节做了一次听觉意义上的压缩。
6.3 log 压缩更适合学习
声音能量的动态范围很大。一个很响的声音可能比很轻的声音能量大几百倍甚至几千倍。直接用线性能量,模型容易被大能量区域支配。
log 压缩可以把乘法比例变成加法差异:
| |
这也更接近人耳对响度的感知方式。
7. 常见参数怎么选?
语音任务里最常见的配置:
| 参数 | 常见值 | 说明 |
|---|---|---|
| sample_rate | 16000 | ASR 常用 16kHz |
| win_length | 400 | 25ms,$16000 \times 0.025 = 400$ |
| hop_length | 160 | 10ms,$16000 \times 0.01 = 160$ |
| n_fft | 512 | FFT 点数,通常不小于 win_length |
| n_mels | 80 | Whisper、Paraformer 等常见取值 |
| f_min | 0 | 最低频率 |
| f_max | 8000 | 16kHz 采样时 Nyquist 频率 |
帧长和帧移的意义:
| |
如果最终特征维度是 80,那么 1 秒音频大约变成:
| |
这已经很像一张小图片了。横轴是时间,纵轴是 Mel 频率,像素值是 log energy。
8. 实践:用 librosa 计算 Mel Spectrogram
先安装依赖:
| |
| |
9. 与 ASR 前端的关系
在 ASR 系统里,Mel Spectrogram 通常是声学前端的第一步。
不同系统叫法可能略有差异:
| 名称 | 常见含义 |
|---|---|
| Mel Spectrogram | Mel 频带能量图,通常可能还没取 log |
| Log-Mel | 取 log 或 dB 后的 Mel 特征 |
| FBank | Filter Bank 特征,在 ASR 中通常就是 Log-Mel filterbank |
| MFCC | 在 Log-Mel 后再做 DCT 得到的倒谱特征 |
现代深度学习 ASR 更常用 Log-Mel / FBank,而不是 MFCC。因为神经网络可以自己学习频带之间的组合关系,不一定需要 DCT 做进一步压缩。
10. 常见坑
10.1 采样率要对齐
模型训练用 16kHz,推理也应该用 16kHz。采样率不一致会导致频率轴整体错位。
10.2 power 和 amplitude 不要混
幅度谱是:
$$ |X| $$
功率谱是:
$$ |X|^2 $$
librosa.feature.melspectrogram(..., power=2.0) 用的是功率谱。不同框架如果这里不一致,特征数值会明显不同。
10.3 log、ln、dB 的差异
有些实现用自然对数:
| |
有些实现用 dB:
| |
它们表达的信息相近,但数值尺度不同。部署模型时要和训练阶段保持一致。
10.4 shape 方向要确认
librosa 常见输出是:
| |
ASR runtime 常见输入是:
| |
这里错了,模型不会报特别明显的错误,但识别结果会很离谱。
11. 总结
Mel Spectrogram 可以理解成三层变换:
- STFT:把波形变成时间-频率图。
- Mel 滤波器组:把线性频率轴变成更接近人耳的 Mel 频率轴。
- log 压缩:把巨大能量范围压缩到更适合模型学习的尺度。
最终得到的 Log-Mel 特征,是一张“人耳友好 + 模型友好”的声音图片。它既保留了语音随时间变化的频率结构,又比原始波形更稳定、更低维、更容易被神经网络使用。